वॉयस और ऑडियो (STT/TTS)
Audio टैब नियंत्रित करता है कि आपका एजेंट कैसे सुनता और बोलता है। speech-to-text (STT) और text-to-speech (TTS) दोनों बहु-प्रदाता हैं — आप एक प्रदाता चुनते हैं, फिर एक मॉडल और प्रदाता-विशिष्ट नियंत्रण। इन्हें सही करना ही किसी एजेंट को स्वाभाविक लगाता है और कॉल करने वालों को सटीक रूप से समझाता है। इसे एजेंट बिल्डर में /agent/setup पर सेट करें।
speech-to-text सेटिंग्स Pipeline वॉयस मोड में लागू होती हैं। realtime मोड (Azure Realtime, Gemini Realtime) में ट्रांसक्रिप्शन प्रदाता द्वारा आंतरिक रूप से संभाला जाता है, इसलिए STT अनुभाग को अनदेखा किया जाता है। वॉयस पाइपलाइन मोड LLM टैब पर सेट करें।
Speech-to-text
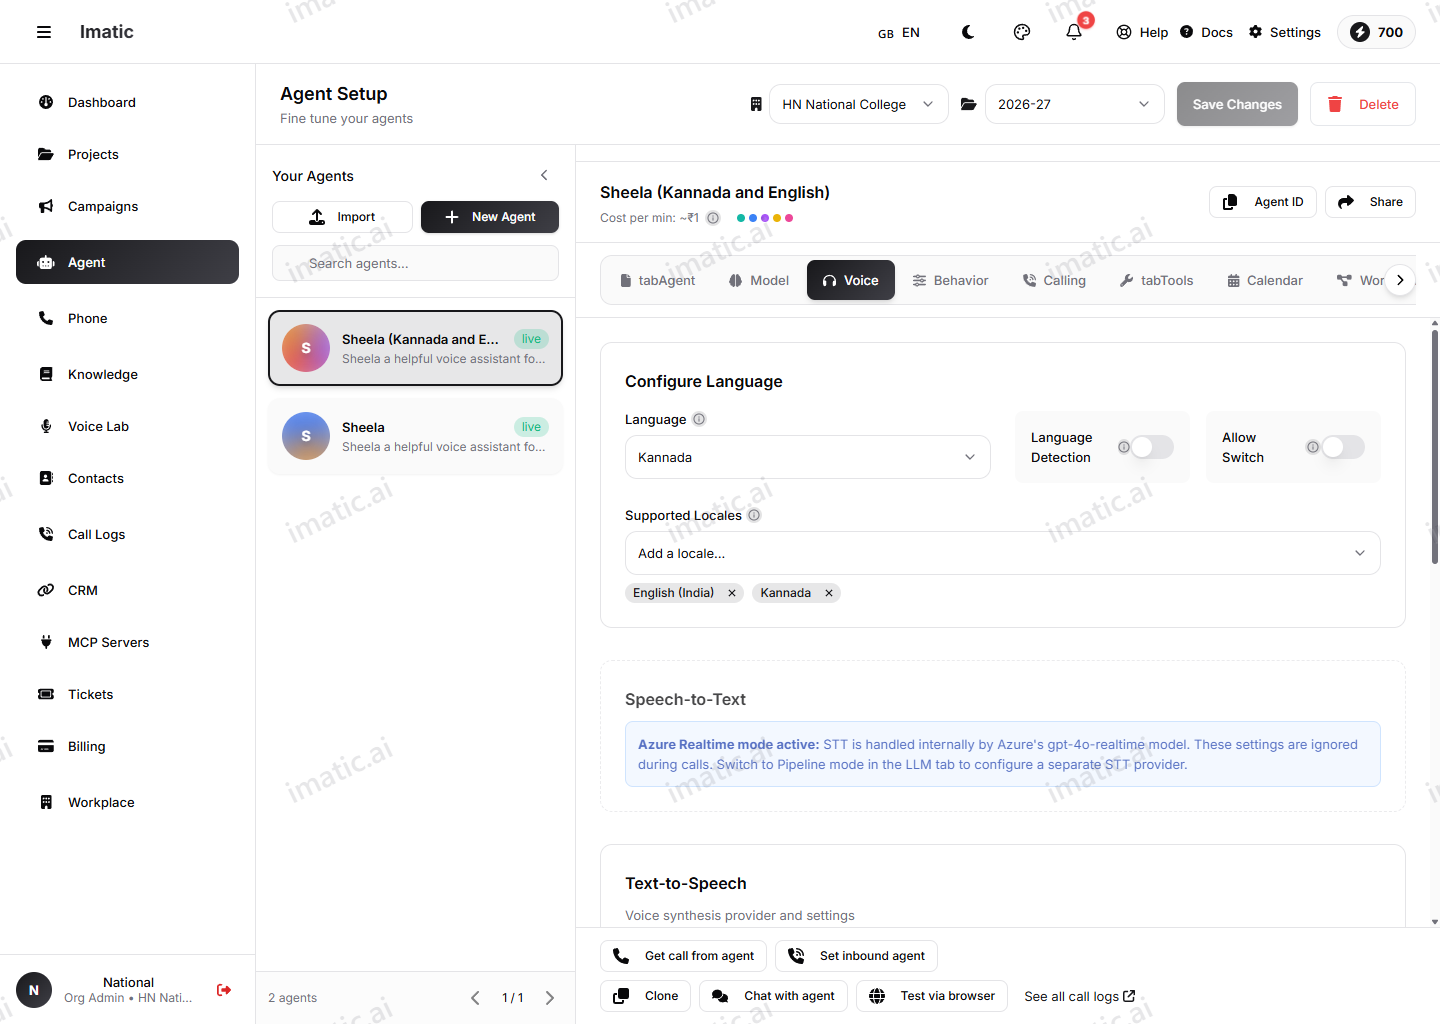
speech-to-text कॉल करने वाले के ऑडियो को ऐसे टेक्स्ट में बदलता है जिस पर एजेंट कार्य कर सके। एक प्रदाता और मॉडल चुनें जो आपके कॉल करने वालों और आपके डोमेन के अनुकूल हों। STT प्रदाताओं में शामिल हैं:
- Deepgram (डिफ़ॉल्ट) — Nova-3 / Nova-2 और अधिक।
- Azure — Default और Conversation मॉडल।
- Groq — Whisper Large v3 / Turbo।
- Sarvam — Saarika (Indic)।
सामान्य नियंत्रण
भाषा, विराम-चिह्न, शब्द टाइमस्टैम्प और अंतरिम परिणाम सभी प्रदाताओं में लागू होते हैं। सही भाषा सेट करना ट्रांसक्रिप्शन सटीकता में सबसे बड़ा एकल कारक है।
प्रदाता-विशिष्ट नियंत्रण
कुछ नियंत्रण केवल उस प्रदाता के लिए दिखाई देते हैं जो उनका समर्थन करता है:
- Deepgram — कीवर्ड बूस्ट, स्मार्ट फ़ॉर्मेट, फिलर हटाना, diarization (ट्रांसक्रिप्ट को वक्ता के अनुसार अलग करना), अपशब्द फ़िल्टर, विकल्प और विलंब मोड।
- Azure — अपशब्द मोड (masked / removed / raw)।
- Sarvam — कोड मिक्सिंग।
आप पहचान सुधारने के लिए कस्टम शब्दावली (उत्पाद नाम, ब्रांड शब्द, शब्दजाल) भी जोड़ सकते हैं, और एंडपॉइंटिंग और VAD टर्नऑफ़ समय ट्यून कर सकते हैं।
ट्रांसक्रिप्ट PII रिडैक्शन (किन संवेदनशील प्रकारों को मास्क करना है) Guardrails टैब पर कॉन्फ़िगर होता है, यहाँ नहीं। देखें गार्डरेल्स और अनुपालन।
Text-to-speech
text-to-speech वह वॉयस है जिससे आपका एजेंट बोलता है। एक प्रदाता, मॉडल और वॉयस चुनें। TTS प्रदाताओं में शामिल हैं:
- ElevenLabs (डिफ़ॉल्ट) — Turbo v2.5 / v2, Multilingual v2।
- Azure — Neural और Standard।
- Google — Gemini TTS।
- Cartesia — Sonic।
- Groq — Orpheus।
- Sarvam — Bulbul (Indic)।
वॉयस
वह वॉयस चुनें जो आपके ब्रांड और आपके कॉल करने वालों के अनुकूल हो। आप Voice Lab में बनाई गई एक कस्टम वॉयस भी उपयोग कर सकते हैं — एक छोटे नमूने से एक वॉयस क्लोन करें और इसे एजेंट को असाइन करें। इसे सुनने के लिए पूर्वावलोकन बटन का उपयोग करें।
सामान्य नियंत्रण
गति, पिच, शैली, वॉल्यूम, भावना, ज़ोर, आउटपुट प्रारूप और कस्टम उच्चारण सभी प्रदाताओं में लागू होते हैं। फ़ोन कॉल पर थोड़ी धीमी बोली का अनुसरण करना आसान होता है, विशेष रूप से संख्याओं, तिथियों और पुष्टिकरण के लिए।
ElevenLabs-विशिष्ट नियंत्रण
स्थिरता, समानता बूस्ट, शैली अतिशयोक्ति और वक्ता बूस्ट ElevenLabs वॉयस नियंत्रण हैं:
- स्थिरता नियंत्रित करती है कि वॉयस वाक्यांश-दर-वाक्यांश कितनी सुसंगत सुनाई देती है — अधिक अधिक स्थिर है, कम अधिक स्वाभाविक भिन्नता की अनुमति देती है।
- समानता बूस्ट आउटपुट को स्रोत वॉयस के करीब रखती है।
- वक्ता बूस्ट मूल वक्ता से समानता बढ़ाता है।
परिवर्तनों को कागज़ पर नहीं, बल्कि ज़ोर से बोलकर परखें। प्रत्येक समायोजन के बाद /agent/interface पर वॉयस परीक्षण का उपयोग करें — गति और उच्चारण की समस्याएँ सुनते ही सेकंडों में स्पष्ट हो जाती हैं।